 |
pulsatrix
|
|
pulsatrix
|
Line-delimited corpus Dataset – tokenizes and indexes each line into a Tensor. More...
#include <string>#include <vector>#include "pulsatrix/dataset.hpp"#include "pulsatrix/device_backend.hpp"#include "pulsatrix/vocabulary.hpp"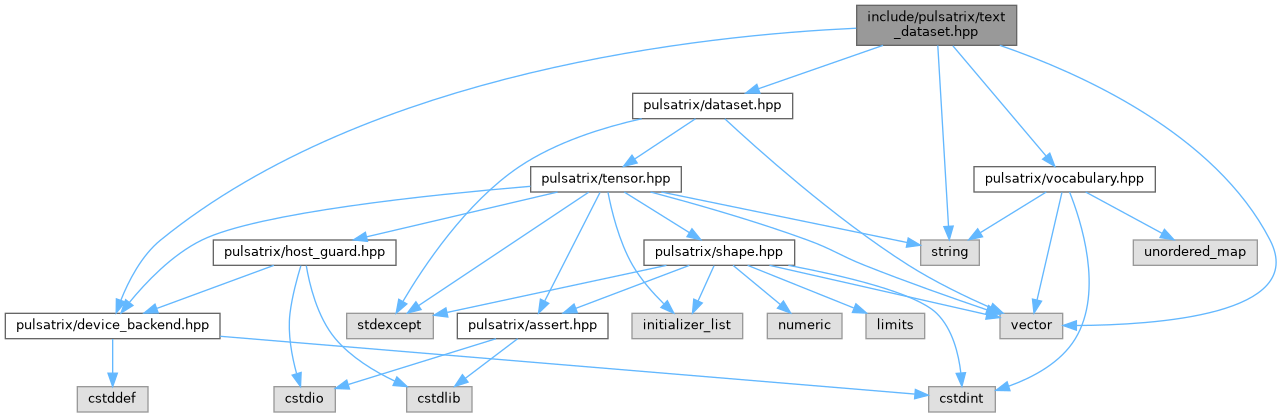
Go to the source code of this file.
Classes | |
| class | pulsatrix::TextDataset |
| Dataset over a line-delimited text corpus: each line becomes one sample, tokenized via Tokenizer::Tokenize and indexed via a Vocabulary into a (1, seq_len) float32 Tensor of token indices – Decision Point 6's resolved representation (token IDs as float32 values, the same integer-as-float32 pattern CsvDataset's label column and MnistDatasetAdapter's class label already use). seq_len varies per sample; no padding here (see PadCollate, Mission 10) – an empty line produces a zero-element (1, 0) Tensor, a valid, non-error Tensor state. More... | |
Namespaces | |
| namespace | pulsatrix |
Line-delimited corpus Dataset – tokenizes and indexes each line into a Tensor.
 1.9.8